

अपने ऐप्लिकेशन को बेहतर परफ़ॉर्मेंस और भरोसेमंद बनाने के लिए, इस दस्तावेज़ को पढ़ें. इससे आपको सोच-समझकर फ़ैसले लेने में मदद मिलेगी. इस दस्तावेज़ में, Cloud Firestore के ऐडवांस विषयों के बारे में बताया गया है. अगर आपने हाल ही में Cloud Firestore का इस्तेमाल शुरू किया है, तो क्विकस्टार्ट गाइड देखें.
Cloud Firestore, Firebase और Google Cloud का एक ऐसा डेटाबेस है जिसे ज़रूरत के हिसाब से बदला जा सकता है और बढ़ाया जा सकता है. इसका इस्तेमाल मोबाइल डिवाइस, वेब, और सर्वर डेवलपमेंट के लिए किया जाता है. Cloud Firestore का इस्तेमाल शुरू करना और बेहतरीन ऐप्लिकेशन बनाना बहुत आसान है.
डेटाबेस का साइज़ और ट्रैफ़िक बढ़ने पर भी आपके ऐप्लिकेशन की परफ़ॉर्मेंस अच्छी बनी रहे, इसके लिए Cloud Firestore बैकएंड में डेटा को पढ़ने और लिखने के तरीके को समझना ज़रूरी है. आपको यह भी समझना होगा कि स्टोरेज लेयर के साथ आपके रीड और राइट ऑपरेशन कैसे इंटरैक्ट करते हैं. साथ ही, आपको उन सीमाओं को भी समझना होगा जिनसे परफ़ॉर्मेंस पर असर पड़ सकता है.
अपना ऐप्लिकेशन बनाने से पहले, सबसे सही तरीके जानने के लिए यहां दिए गए सेक्शन देखें.
हाई लेवल कॉम्पोनेंट के बारे में जानकारी
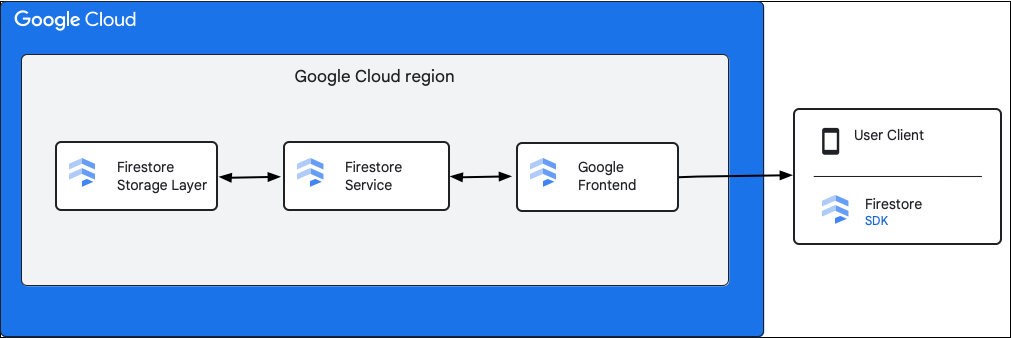
यहां दिए गए डायग्राम में, Cloud Firestore एपीआई अनुरोध में शामिल हाई लेवल कॉम्पोनेंट दिखाए गए हैं.
Cloud Firestore SDK टूल और क्लाइंट लाइब्रेरी
Cloud Firestore, अलग-अलग प्लैटफ़ॉर्म के लिए एसडीके और क्लाइंट लाइब्रेरी के साथ काम करता है. कोई ऐप्लिकेशन, Cloud Firestore एपीआई को सीधे एचटीटीपी और आरपीसी कॉल कर सकता है. हालांकि, क्लाइंट लाइब्रेरी, एपीआई के इस्तेमाल को आसान बनाने और सबसे सही तरीके लागू करने के लिए, एब्स्ट्रैक्शन की एक लेयर उपलब्ध कराती हैं. इनमें बिना इंटरनेट के इस्तेमाल, कैश मेमोरी जैसी अन्य सुविधाएं भी मिल सकती हैं.
Google फ़्रंट एंड (GFE)
यह एक इंफ़्रास्ट्रक्चर सेवा है, जो Google की सभी क्लाउड सेवाओं के लिए उपलब्ध है. GFE, आने वाले अनुरोधों को स्वीकार करता है और उन्हें Google की संबंधित सेवा (इस मामले में Cloud Firestore सेवा) पर फ़ॉरवर्ड करता है. यह अन्य ज़रूरी सुविधाएं भी उपलब्ध कराता है. इनमें डिनायल ऑफ़ सर्विस अटैक से सुरक्षा भी शामिल है.
Cloud Firestore सेवा
Cloud Firestore सेवा, एपीआई अनुरोध की जांच करती है. इसमें पुष्टि, अनुमति, कोटा की जांच, और सुरक्षा के नियम शामिल हैं. साथ ही, यह लेन-देन को मैनेज करती है. इस Cloud Firestore सेवा में एक स्टोरेज क्लाइंट शामिल होता है, जो डेटा को पढ़ने और लिखने के लिए स्टोरेज लेयर के साथ इंटरैक्ट करता है.
Cloud Firestore स्टोरेज लेयर
Cloud Firestore स्टोरेज लेयर, डेटा और मेटाडेटा, दोनों को सेव करने के लिए ज़िम्मेदार है. साथ ही, यह Cloud Firestore से जुड़ी डेटाबेस की सुविधाओं को सेव करने के लिए भी ज़िम्मेदार है. यहां दिए गए सेक्शन में बताया गया है कि Cloud Firestore स्टोरेज लेयर में डेटा को कैसे व्यवस्थित किया जाता है और सिस्टम कैसे स्केल करता है. डेटा को व्यवस्थित करने का तरीका जानने से, आपको बढ़ाए जा सकने वाले डेटा मॉडल को डिज़ाइन करने में मदद मिल सकती है. साथ ही, Cloud Firestore में सबसे सही तरीकों को बेहतर तरीके से समझा जा सकता है.
मुख्य रेंज और स्प्लिट
Cloud Firestore एक NoSQL, दस्तावेज़-ओरिएंटेड डेटाबेस है. डेटा को दस्तावेज़ों में सेव किया जाता है. ये दस्तावेज़, कलेक्शन के क्रम में व्यवस्थित होते हैं. कलेक्शन की हैरारकी और दस्तावेज़ आईडी को हर दस्तावेज़ के लिए एक कुंजी में बदला जाता है. दस्तावेज़ों को लॉजिकल तरीके से स्टोर किया जाता है और इस सिंगल कुंजी के हिसाब से, वर्णमाला के क्रम में लगाया जाता है. हम कुंजियों की लेक्सिकोग्राफ़िकली कॉन्टिगुअस रेंज को बताने के लिए, कुंजी की रेंज शब्द का इस्तेमाल करते हैं.
आम तौर पर, Cloud Firestore डेटाबेस का साइज़ इतना बड़ा होता है कि उसे एक ही फ़िज़िकल मशीन पर सेव नहीं किया जा सकता. कुछ मामलों में, डेटा का वर्कलोड इतना ज़्यादा होता है कि उसे एक मशीन से मैनेज नहीं किया जा सकता. ज़्यादा वर्कलोड को मैनेज करने के लिए, Cloud Firestore डेटा को अलग-अलग हिस्सों में बांटता है. इन्हें कई मशीनों या स्टोरेज सर्वर पर सेव किया जा सकता है और वहां से ऐक्सेस किया जा सकता है. ये पार्टिशन, डेटाबेस टेबल में मुख्य रेंज के ब्लॉक में बनाए जाते हैं. इन्हें स्प्लिट कहा जाता है.
सिंक्रोनस रेप्लिकेशन
यह ध्यान रखना ज़रूरी है कि डेटाबेस को हमेशा अपने-आप और एक साथ रेप्लिकेट किया जाता है. डेटा के हिस्सों की कॉपी अलग-अलग ज़ोन में मौजूद होती हैं. इससे किसी ज़ोन के ऐक्सेस न होने पर भी डेटा उपलब्ध रहता है. स्प्लिट की अलग-अलग कॉपी में डेटा को एक जैसा बनाए रखने के लिए, Paxos एल्गोरिदम का इस्तेमाल किया जाता है. हर स्प्लिट की एक रेप्लिका को Paxos लीडर के तौर पर चुना जाता है. यह लीडर, उस स्प्लिट में डेटा लिखने की प्रोसेस को मैनेज करता है. सिंक्रोनस रेप्लिकेशन की मदद से, Cloud Firestore से डेटा का नया वर्शन हमेशा पढ़ा जा सकता है.
इसका कुल नतीजा यह होता है कि सिस्टम को ज़रूरत के हिसाब से बढ़ाया जा सकता है और यह बहुत ज़्यादा अपटाइम देता है. साथ ही, डेटा को पढ़ने और लिखने, दोनों के लिए कम इंतज़ार करना पड़ता है. भले ही, वर्कलोड ज़्यादा हो और बड़े पैमाने पर हो.
डेटा लेआउट
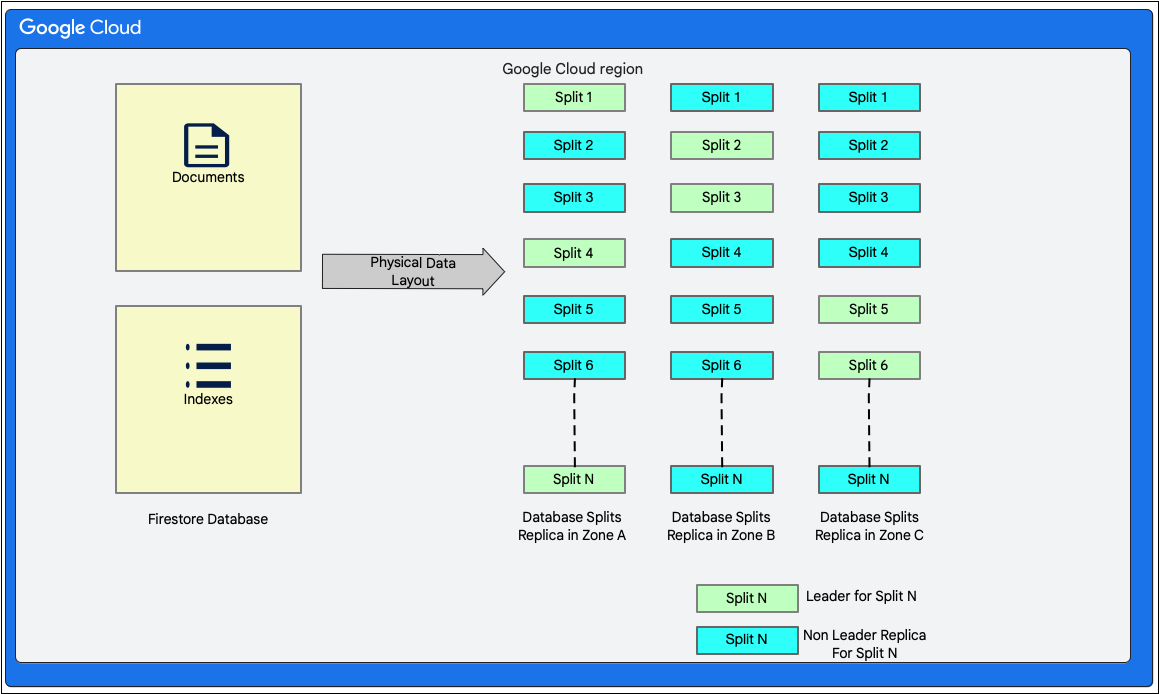
Cloud Firestore, स्कीमा के बिना काम करने वाला दस्तावेज़ डेटाबेस है. हालांकि, यह डेटा को मुख्य रूप से अपनी स्टोरेज लेयर में, रिलेशनल डेटाबेस-स्टाइल वाली दो टेबल में इस तरह से दिखाता है:
- दस्तावेज़ टेबल: दस्तावेज़ इस टेबल में सेव किए जाते हैं.
- इंडेक्स टेबल: इस टेबल में इंडेक्स की ऐसी एंट्री सेव की जाती हैं जिनकी मदद से, बेहतर तरीके से नतीजे पाए जा सकते हैं. साथ ही, इंडेक्स की वैल्यू के हिसाब से नतीजों को क्रम से लगाया जा सकता है.
इस डायग्राम में दिखाया गया है कि स्प्लिट के साथ Cloud Firestore डेटाबेस की टेबल कैसी दिख सकती हैं. स्प्लिट को तीन अलग-अलग ज़ोन में रेप्लिकेट किया जाता है. साथ ही, हर स्प्लिट के लिए एक Paxos लीडर असाइन किया जाता है.
सिंगल रीजन बनाम मल्टी-रीजन
डेटाबेस बनाते समय, आपको कोई क्षेत्र या एक से ज़्यादा क्षेत्र चुनने होंगे.
एक रीजनल लोकेशन, कोई खास भौगोलिक जगह होती है. जैसे, us-west1. Cloud Firestore डेटाबेस के डेटा के स्प्लिट की कॉपी, चुने गए क्षेत्र के अलग-अलग ज़ोन में मौजूद होती हैं. इस बारे में पहले बताया गया है.
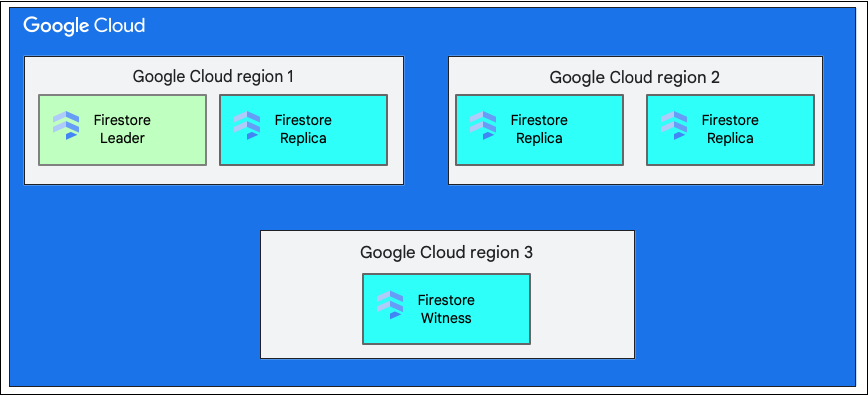
एक से ज़्यादा इलाकों वाली जगह में, तय किए गए इलाकों का एक सेट होता है. इसमें डेटाबेस की कॉपी सेव की जाती हैं. Cloud Firestore को एक से ज़्यादा क्षेत्रों में डिप्लॉय करने पर, डेटाबेस में मौजूद पूरे डेटा की पूरी कॉपी दो क्षेत्रों में मौजूद होती है. तीसरे इलाके में विटनेस रेप्लिका होता है. इसमें डेटा का पूरा सेट नहीं होता, लेकिन यह डेटा को कॉपी करने की प्रोसेस में हिस्सा लेता है. एक से ज़्यादा क्षेत्रों में डेटा को कॉपी करने से, डेटा को लिखा और पढ़ा जा सकता है. भले ही, किसी पूरे क्षेत्र का डेटा मिट गया हो.
किसी देश या इलाके की जगहों के बारे में ज़्यादा जानने के लिए, Cloud Firestore की जगहें देखें.
Cloud Firestore में लेखक के तौर पर जीवन को समझना
Cloud Firestore क्लाइंट, किसी एक दस्तावेज़ को बनाकर, अपडेट करके या मिटाकर डेटा लिख सकता है. किसी एक दस्तावेज़ में डेटा लिखने के लिए, स्टोरेज लेयर में दस्तावेज़ और उससे जुड़े इंडेक्स के रिकॉर्ड, दोनों को एक साथ अपडेट करना ज़रूरी है. Cloud Firestore, ऐटॉमिक ऑपरेशन के साथ भी काम करता है. इसमें एक या इससे ज़्यादा दस्तावेज़ों को कई बार पढ़ा और/या लिखा जा सकता है.
सभी तरह के राइट के लिए, Cloud Firestore रिलेशनल डेटाबेस की एसीआईडी प्रॉपर्टी (एटमिसिटी, कंसिस्टेंसी, आइसोलेशन, और ड्यूरेबिलिटी) उपलब्ध कराता है. Cloud Firestore, सीरियलाइज़ेबिलिटी की सुविधा भी देता है. इसका मतलब है कि सभी लेन-देन, सीरियल ऑर्डर में किए गए लेन-देन की तरह दिखते हैं.
राइट ट्रांज़ैक्शन के लिए ज़रूरी चरण
जब Cloud Firestore क्लाइंट, ऊपर बताए गए किसी भी तरीके का इस्तेमाल करके, डेटा को सेव करने या लेन-देन करने का निर्देश देता है, तो स्टोरेज लेयर में इसे डेटाबेस रीड-राइट ट्रांज़ैक्शन के तौर पर लागू किया जाता है. इस लेन-देन की मदद से, Cloud Firestore पहले बताई गई ACID प्रॉपर्टी उपलब्ध करा पाता है.
लेन-देन के पहले चरण के तौर पर, Cloud Firestore मौजूदा दस्तावेज़ को पढ़ता है. साथ ही, यह तय करता है कि दस्तावेज़ों की टेबल में मौजूद डेटा में क्या बदलाव करने हैं.
इसमें इंडेक्स टेबल में ज़रूरी अपडेट करना भी शामिल है, जैसा कि यहां बताया गया है:
- दस्तावेज़ों में जोड़े जा रहे फ़ील्ड के लिए, इंडेक्स टेबल में उनसे जुड़े इंसर्ट होने चाहिए.
- दस्तावेज़ों से हटाए जा रहे फ़ील्ड को इंडेक्स टेबल से भी मिटाना होगा.
- दस्तावेज़ों में जिन फ़ील्ड में बदलाव किया जा रहा है उनके लिए, इंडेक्स टेबल में पुरानी वैल्यू को मिटाना और नई वैल्यू को शामिल करना ज़रूरी है.
पहले बताए गए म्यूटेशन का हिसाब लगाने के लिए, Cloud Firestore डेटाबेस के लिए इंडेक्सिंग कॉन्फ़िगरेशन को पढ़ता है. इंडेक्सिंग कॉन्फ़िगरेशन में, डेटाबेस के इंडेक्स की जानकारी सेव होती है. Cloud Firestore दो तरह के इंडेक्स का इस्तेमाल करता है: सिंगल-फ़ील्ड और कंपोज़िट. Cloud Firestore में बनाए गए इंडेक्स के बारे में ज़्यादा जानने के लिए, Cloud Firestore में इंडेक्स के टाइप देखें.
म्यूटेशन का हिसाब लगाने के बाद, Cloud Firestore उन्हें एक लेन-देन में इकट्ठा करता है और फिर उसे लागू करता है.
स्टोरेज लेयर में राइट ट्रांज़ैक्शन को समझना
जैसा कि पहले बताया गया है, Cloud Firestore में डेटा लिखने के लिए, स्टोरेज लेयर में रीड-राइट ट्रांज़ैक्शन की ज़रूरत होती है. डेटा के लेआउट के आधार पर, डेटा को सेव करने के लिए एक या उससे ज़्यादा स्प्लिट की ज़रूरत पड़ सकती है. जैसा कि डेटा लेआउट में देखा जा सकता है.
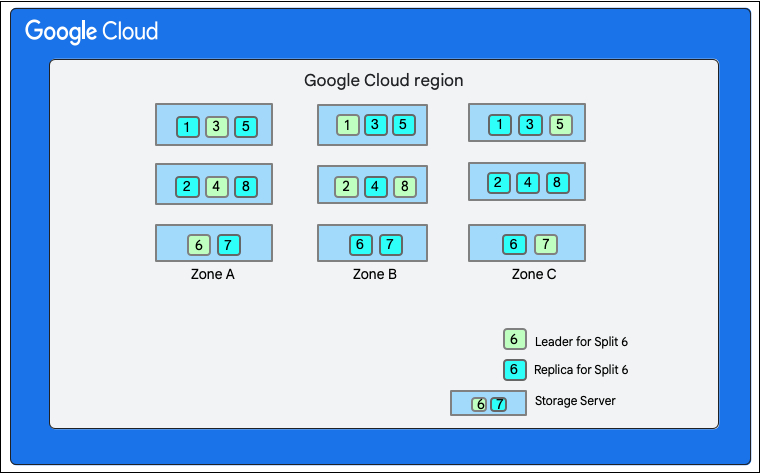
यहां दिए गए डायग्राम में, Cloud Firestore डेटाबेस में आठ स्प्लिट (1 से 8 तक मार्क किए गए) हैं. इन्हें एक ही ज़ोन में तीन अलग-अलग स्टोरेज सर्वर पर होस्ट किया गया है. साथ ही, हर स्प्लिट को तीन (या इससे ज़्यादा) अलग-अलग ज़ोन में रेप्लिकेट किया गया है. हर स्प्लिट का एक Paxos लीडर होता है, जो अलग-अलग स्प्लिट के लिए अलग-अलग ज़ोन में हो सकता है.
 Cloud Firestore database split">
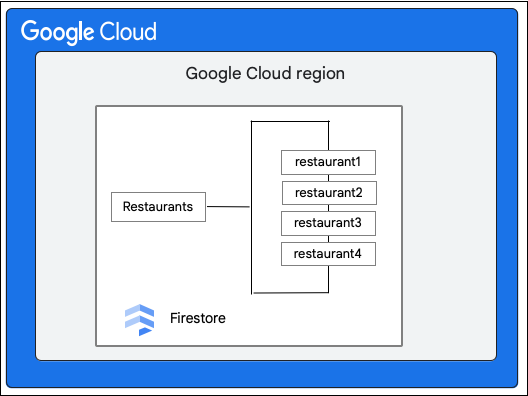
मान लें कि आपके पास एक Cloud Firestore डेटाबेस है, जिसमें Restaurants कलेक्शन इस तरह है:
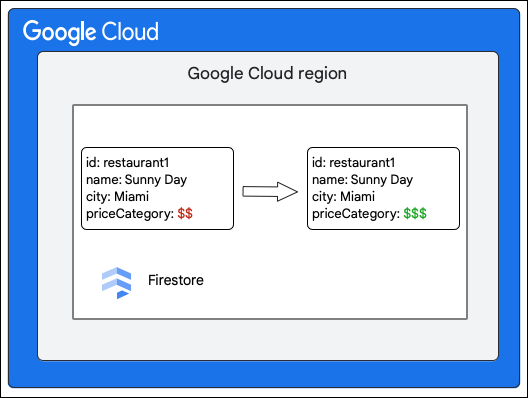
Cloud Firestore क्लाइंट, priceCategory फ़ील्ड की वैल्यू को अपडेट करके, Restaurant कलेक्शन में मौजूद किसी दस्तावेज़ में यह बदलाव करने का अनुरोध करता है.
यहां दिए गए चरणों में बताया गया है कि डेटा लिखने के दौरान क्या होता है:
- रीड-राइट ट्रांज़ैक्शन बनाना.
- स्टोरेज लेयर में मौजूद दस्तावेज़ टेबल से,
Restaurantsकलेक्शन में मौजूदrestaurant1दस्तावेज़ को पढ़ना. - इंडेक्स टेबल से, दस्तावेज़ के इंडेक्स पढ़ें.
- डेटा में किए जाने वाले बदलावों का हिसाब लगाएं. इस मामले में, पांच म्यूटेशन हैं:
- M1: दस्तावेज़ टेबल में
restaurant1की लाइन को अपडेट करें, ताकिpriceCategoryफ़ील्ड की वैल्यू में हुए बदलाव को दिखाया जा सके. - M2 और M3: घटते और बढ़ते क्रम में इंडेक्स के लिए, इंडेक्स टेबल में
priceCategoryकी पुरानी वैल्यू वाली लाइनें मिटाएं. - M4 और M5: घटते और बढ़ते इंडेक्स के लिए, इंडेक्स टेबल में
priceCategoryकी नई वैल्यू के लिए लाइनें डालें.
- M1: दस्तावेज़ टेबल में
- इन म्यूटेशन को लागू करें.
Cloud Firestore सेवा में मौजूद स्टोरेज क्लाइंट, उन स्प्लिट को खोजता है जिनके पास उन पंक्तियों की कुंजियां होती हैं जिनमें बदलाव करना है. मान लें कि स्प्लिट 3, M1 को और स्प्लिट 6, M2-M5 को दिखाता है. एक डिस्ट्रिब्यूटेड लेन-देन है, जिसमें ये सभी स्प्लिट हिस्सेदार के तौर पर शामिल हैं. हिस्सा लेने वाले स्प्लिट में, कोई ऐसा स्प्लिट भी शामिल हो सकता है जिससे डेटा को पहले रीड-राइट ट्रांज़ैक्शन के हिस्से के तौर पर पढ़ा गया था.
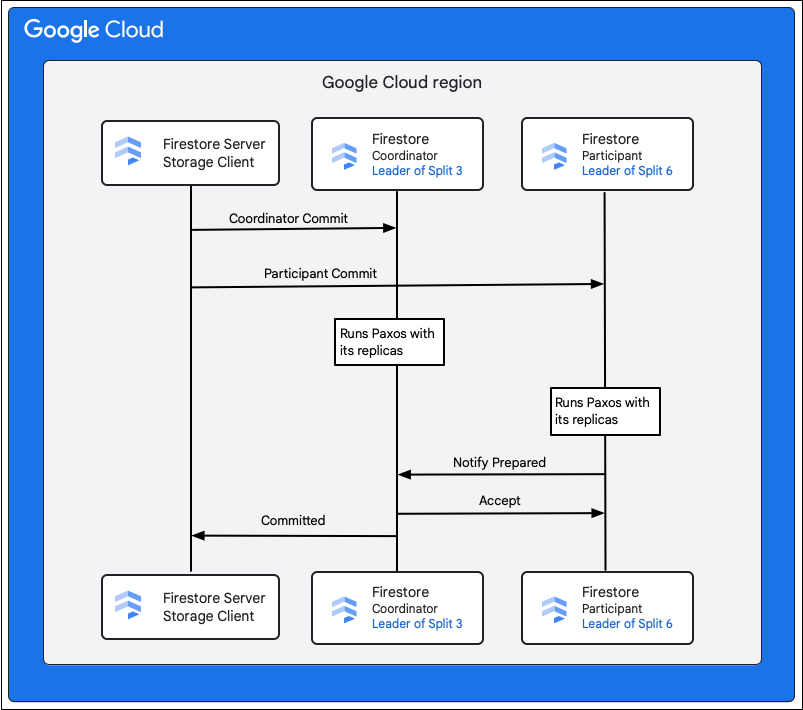
यहां बताया गया है कि कमिट करने पर क्या होता है:
- स्टोरेज क्लाइंट, कमिट जारी करता है. इस कमिट में M1-M5 म्यूटेशन शामिल हैं.
- इस लेन-देन में, स्प्लिट 3 और 6 शामिल हैं. हिस्सा लेने वाले लोगों में से किसी एक को कोऑर्डिनेटर के तौर पर चुना जाता है. जैसे, स्प्लिट 3. कोऑर्डिनेटर का काम यह पक्का करना है कि लेन-देन, सभी पक्षों के बीच पूरी तरह से हो या रद्द हो जाए.
- इन स्प्लिट की लीडर रेप्लिका, हिस्सा लेने वाले लोगों और कोऑर्डिनेटर के काम के लिए ज़िम्मेदार होती हैं.
- हिस्सा लेने वाला हर व्यक्ति और कोऑर्डिनेटर, अपनी-अपनी प्रतिकृतियों के साथ Paxos एल्गोरिदम चलाता है.
- लीडर, रेप्लिका के साथ पैक्सोस एल्गोरिदम चलाता है. अगर ज़्यादातर रेप्लिका, लीडर को
ok to commitजवाब देते हैं, तो कोरम पूरा हो जाता है. - इसके बाद, हर पार्टिसिपेंट कोऑर्डिनेटर को सूचना देता है कि वह तैयार है (दो चरणों वाले कमिट का पहला चरण). अगर हिस्सा लेने वाला कोई व्यक्ति लेन-देन नहीं कर पाता है, तो पूरा लेन-देन
aborts.
- लीडर, रेप्लिका के साथ पैक्सोस एल्गोरिदम चलाता है. अगर ज़्यादातर रेप्लिका, लीडर को
- जब कोऑर्डिनेटर को पता चलता है कि हिस्सा लेने वाले सभी लोग तैयार हैं, तो वह सभी को
acceptलेन-देन के नतीजे के बारे में बताता है. यह टू-फ़ेज़ कमिट का दूसरा फ़ेज़ होता है. इस फ़ेज़ में, हिस्सा लेने वाला हर व्यक्ति कमिट करने के फ़ैसले को स्टेबल स्टोरेज में रिकॉर्ड करता है और लेन-देन कमिट हो जाता है. - कोऑर्डिनेटर, स्टोरेज क्लाइंट को Cloud Firestore में जवाब देता है कि लेन-देन पूरा हो गया है. इसके साथ ही, कोऑर्डिनेटर और हिस्सा लेने वाले सभी लोग, डेटा में बदलाव करते हैं.
जब Cloud Firestore डेटाबेस छोटा होता है, तो ऐसा हो सकता है कि एक ही स्प्लिट में, म्यूटेशन M1-M5 की सभी कुंजियां हों. ऐसे मामले में, लेन-देन में सिर्फ़ एक हिस्सा लेने वाला व्यक्ति होता है. साथ ही, पहले बताए गए दो चरणों वाले कमिट की ज़रूरत नहीं होती. इससे डेटा को तेज़ी से लिखा जा सकता है.
मल्टी-रीजन में डेटा सेव करना
एक से ज़्यादा क्षेत्रों में डिप्लॉयमेंट करने पर, अलग-अलग क्षेत्रों में रेप्लिका को स्प्रेड करने से उपलब्धता बढ़ती है. हालांकि, इससे परफ़ॉर्मेंस पर असर पड़ता है. अलग-अलग इलाकों में मौजूद रेप्लिका के बीच कम्यूनिकेशन में, दोतरफ़ा यात्रा का समय ज़्यादा लगता है. इसलिए, Cloud Firestore ऑपरेशन के लिए बेसलाइन लेटेंसी, एक ही देश/इलाके में डिप्लॉयमेंट की तुलना में थोड़ी ज़्यादा होती है.
हम रेप्लिका को इस तरह से कॉन्फ़िगर करते हैं कि स्प्लिट के लिए लीडरशिप हमेशा प्राइमरी रीजन में रहे. प्राइमरी रीजन वह क्षेत्र होता है जहां से Cloud Firestore सर्वर पर ट्रैफ़िक आता है. लीडरशिप के इस फ़ैसले से, Cloud Firestore में मौजूद स्टोरेज क्लाइंट और रेप्लिका लीडर (या मल्टी-स्प्लिट ट्रांज़ैक्शन के लिए कोऑर्डिनेटर) के बीच कम्यूनिकेशन में लगने वाला समय कम हो जाता है.
Cloud Firestore में हर बार डेटा सेव करने पर, Cloud Firestore में रीयल-टाइम इंजन के साथ भी कुछ इंटरैक्शन होता है. रीयल-टाइम क्वेरी के बारे में ज़्यादा जानने के लिए, बड़े पैमाने पर रीयल-टाइम क्वेरी को समझना लेख पढ़ें.
Cloud Firestore में, किसी कॉन्टेंट को पढ़ने के बारे में जानकारी
इस सेक्शन में, Cloud Firestore में रीयल-टाइम में न होने वाली अलग-अलग रीड के बारे में बताया गया है. Cloud Firestore सर्वर, इनमें से ज़्यादातर क्वेरी को दो मुख्य चरणों में हैंडल करता है:
- इंडेक्स टेबल पर सिंगल रेंज स्कैन
- पहले किए गए स्कैन के नतीजे के आधार पर, दस्तावेज़ टेबल में पॉइंट लुकअप
स्टोरेज लेयर से डेटा को पढ़ने की प्रोसेस, डेटाबेस ट्रांज़ैक्शन का इस्तेमाल करके अंदरूनी तौर पर की जाती है. इससे यह पक्का किया जाता है कि डेटा को लगातार पढ़ा जा सके. हालांकि, डेटा लिखने के लिए इस्तेमाल किए जाने वाले लेन-देन के उलट, ये लेन-देन लॉक नहीं होते. इसके बजाय, ये टाइमस्टैंप चुनकर काम करते हैं. इसके बाद, उस टाइमस्टैंप पर सभी रीड को लागू करते हैं. इनमें लॉक नहीं होते हैं. इसलिए, ये एक साथ होने वाले रीड-राइट ट्रांज़ैक्शन को ब्लॉक नहीं करते हैं. इस लेन-देन को पूरा करने के लिए, Cloud Firestore में मौजूद स्टोरेज क्लाइंट, टाइमस्टैंप की सीमा तय करता है. इससे स्टोरेज लेयर को पता चलता है कि रीड टाइमस्टैंप कैसे चुनना है. Cloud Firestore में स्टोरेज क्लाइंट ने टाइमस्टैंप बाउंड का कौनसा टाइप चुना है, यह Read अनुरोध के लिए पढ़ने के विकल्पों से तय होता है.
स्टोरेज लेयर में रीड ट्रांज़ैक्शन को समझना
इस सेक्शन में, रीड के टाइप और Cloud Firestore में स्टोरेज लेयर में उन्हें प्रोसेस करने के तरीके के बारे में बताया गया है.
सबसे ज़्यादा पढ़ी गई खबरें
डिफ़ॉल्ट रूप से, Cloud Firestore रीड मज़बूत अनुकूलता वाले होते हैं. इस मज़बूत अनुकूलता का मतलब है कि Cloud Firestore रीड, डेटा का नया वर्शन दिखाता है. इसमें, रीड शुरू होने तक किए गए सभी राइट शामिल होते हैं.
सिंगल स्प्लिट रीड
Cloud Firestore में मौजूद स्टोरेज क्लाइंट, उन स्प्लिट को खोजता है जिनके पास पढ़ी जाने वाली पंक्तियों की कुंजियां होती हैं. मान लें कि इसे पिछले सेक्शन के स्प्लिट 3 से डेटा पढ़ना है. क्लाइंट, डेटा पढ़ने का अनुरोध सबसे नज़दीकी प्रतिरूप को भेजता है, ताकि दोतरफ़ा यात्रा के इंतज़ार का समय कम किया जा सके.
इस समय, चुने गए प्रतिरूप के आधार पर ये मामले हो सकते हैं:
- डेटा पढ़ने का अनुरोध, लीडर रेप्लिका (ज़ोन A) के पास जाता है.
- लीडर हमेशा अप-टू-डेट रहता है. इसलिए, डेटा को सीधे पढ़ा जा सकता है.
- रीड रिक्वेस्ट, नॉन-लीडर रेप्लिका (जैसे, ज़ोन बी) के पास जाती है
- स्प्लिट 3 को अपने इंटरनल स्टेट से पता चल सकता है कि उसके पास पढ़ने के लिए ज़रूरी जानकारी है. इसके बाद, स्प्लिट उस जानकारी को उपलब्ध कराता है.
- स्प्लिट 3 को पक्का नहीं है कि उसने नया डेटा देखा है या नहीं. यह लीडर को एक मैसेज भेजकर, आखिरी लेन-देन का टाइमस्टैंप मांगता है. इस टाइमस्टैंप को लागू करके, डेटा को पढ़ा जा सकता है. लेन-देन लागू होने के बाद, डेटा को पढ़ा जा सकता है.
Cloud Firestore इसके बाद, अपने क्लाइंट को जवाब देता है.
मल्टी-स्प्लिट रीड
अगर डेटा को कई हिस्सों से पढ़ना है, तो सभी हिस्सों में एक ही तरीका अपनाया जाता है. सभी स्प्लिट से डेटा मिलने के बाद, Cloud Firestore में मौजूद स्टोरेज क्लाइंट, नतीजों को जोड़ता है. इसके बाद, Cloud Firestore इस डेटा के साथ अपने क्लाइंट को जवाब देता है.
Stale reads
Cloud Firestore में, स्ट्रॉन्ग रीड डिफ़ॉल्ट मोड होता है. हालांकि, लीडर के साथ कम्यूनिकेशन की ज़रूरत की वजह से, इंतज़ार का समय बढ़ सकता है. अक्सर आपके Cloud Firestore ऐप्लिकेशन को डेटा का नया वर्शन पढ़ने की ज़रूरत नहीं होती. साथ ही, कुछ सेकंड पुराने डेटा के साथ भी फ़ंक्शन ठीक से काम करता है.
ऐसे मामले में, क्लाइंट read_time रीड ऑप्शन का इस्तेमाल करके, पुराना डेटा पढ़ने का विकल्प चुन सकता है. इस मामले में, डेटा को read_time के हिसाब से पढ़ा जाता है. साथ ही, इस बात की काफ़ी संभावना है कि सबसे नज़दीकी प्रतिरूप ने पहले ही पुष्टि कर ली हो कि उसके पास तय किए गए read_time का डेटा है.
बेहतर परफ़ॉर्मेंस के लिए, 15 सेकंड की वैल्यू सही है. पुराने डेटा को पढ़ने पर भी, पंक्तियों से मिलने वाला डेटा एक जैसा होता है.
हॉटस्पॉट से बचें
Cloud Firestore में मौजूद स्प्लिट, अपने-आप छोटे-छोटे हिस्सों में बंट जाते हैं. ऐसा इसलिए होता है, ताकि ज़रूरत पड़ने पर या की स्पेस बढ़ने पर, ट्रैफ़िक को ज़्यादा स्टोरेज सर्वर पर बांटा जा सके. ज़्यादा ट्रैफ़िक को मैनेज करने के लिए बनाए गए स्प्लिट, ट्रैफ़िक कम होने के बाद भी करीब 24 घंटों तक बने रहते हैं. इसलिए, अगर ट्रैफ़िक में बार-बार बढ़ोतरी होती है, तो स्प्लिट को बनाए रखा जाता है. साथ ही, ज़रूरत पड़ने पर और स्प्लिट जोड़े जाते हैं. इन तरीकों से, Cloud Firestore डेटाबेस को ट्रैफ़िक लोड या डेटाबेस का साइज़ बढ़ने पर, अपने-आप स्केल होने में मदद मिलती है. हालांकि, इसकी कुछ सीमाएं हैं. इनके बारे में यहां बताया गया है.
स्टोरेज और लोड को बांटने में समय लगता है. साथ ही, ट्रैफ़िक को बहुत तेज़ी से बढ़ाने पर, इंतज़ार का समय ज़्यादा हो सकता है या समयसीमा खत्म होने से जुड़ी गड़बड़ियां हो सकती हैं. आम तौर पर, इन्हें हॉटस्पॉट कहा जाता है. हालांकि, सेवा में बदलाव होने पर ये गड़बड़ियां ठीक हो जाती हैं. सबसे सही तरीका यह है कि ऑपरेशन को मुख्य रेंज में बांटें. साथ ही, डेटाबेस में किसी कलेक्शन पर ट्रैफ़िक को हर सेकंड 500 ऑपरेशन तक बढ़ाएं. इस तरह धीरे-धीरे ट्रैफ़िक बढ़ाने के बाद, हर पांच मिनट में ट्रैफ़िक को 50% तक बढ़ाएं. इस प्रोसेस को 500/50/5 नियम कहा जाता है. यह डेटाबेस को इस तरह से पोज़िशन करता है कि वह आपके वर्कलोड को पूरा करने के लिए, बेहतर तरीके से स्केल कर सके.
लोड बढ़ने पर स्प्लिट अपने-आप बन जाते हैं. हालांकि, Cloud Firestore किसी कुंजी की रेंज को सिर्फ़ तब तक स्प्लिट कर सकता है, जब तक वह रेप्लिकेट किए गए स्टोरेज सर्वर के खास सेट का इस्तेमाल करके, एक दस्तावेज़ को सेव कर रहा हो. इस वजह से, किसी एक दस्तावेज़ पर एक साथ कई कार्रवाइयां करने से, उस दस्तावेज़ पर हॉटस्पॉट बन सकता है. अगर आपको किसी एक दस्तावेज़ पर लगातार ज़्यादा इंतज़ार करना पड़ रहा है, तो आपको अपने डेटा मॉडल में बदलाव करना चाहिए. इससे डेटा को कई दस्तावेज़ों में बांटा जा सकता है या उसकी कॉपी बनाई जा सकती है.
कॉन्टेंशन एरर तब होती हैं, जब एक से ज़्यादा ऑपरेशन एक ही समय पर एक ही दस्तावेज़ को पढ़ने और/या उसमें बदलाव करने की कोशिश करते हैं.
हॉटस्पॉटिंग का एक और खास मामला तब होता है, जब Cloud Firestore में दस्तावेज़ आईडी के तौर पर, क्रम से बढ़ने या घटने वाली कुंजी का इस्तेमाल किया जाता है. साथ ही, हर सेकंड होने वाली कार्रवाइयों की संख्या काफ़ी ज़्यादा होती है. ज़्यादा स्प्लिट बनाने से यहां मदद नहीं मिलती, क्योंकि ट्रैफ़िक में बढ़ोतरी नए बनाए गए स्प्लिट पर चली जाती है. Cloud Firestore, डिफ़ॉल्ट रूप से दस्तावेज़ के सभी फ़ील्ड को अपने-आप इंडेक्स करता है. इसलिए, ऐसे मूविंग हॉटस्पॉट, दस्तावेज़ के किसी ऐसे फ़ील्ड के इंडेक्स स्पेस पर भी बनाए जा सकते हैं जिसमें टाइमस्टैंप जैसी लगातार बढ़ने/घटने वाली वैल्यू शामिल हो.
ध्यान दें कि ऊपर बताए गए तरीकों को अपनाकर, Cloud Firestore को किसी भी बड़े वर्कलोड के लिए इस्तेमाल किया जा सकता है. इसके लिए, आपको किसी भी कॉन्फ़िगरेशन में बदलाव करने की ज़रूरत नहीं है.
समस्या का हल
Cloud Firestore, Key Visualizer को डाइग्नोस्टिक टूल के तौर पर उपलब्ध कराता है. इसे इस्तेमाल के पैटर्न का विश्लेषण करने और हॉटस्पॉट से जुड़ी समस्याओं को हल करने के लिए डिज़ाइन किया गया है.
आगे क्या करना है
- सबसे सही तरीकों के बारे में ज़्यादा जानें
- बड़े पैमाने पर रीयल-टाइम क्वेरी के बारे में जानें