

Прочитайте этот документ, чтобы принимать обоснованные решения при проектировании приложений с высокой производительностью и надежностью. В этом документе рассматриваются расширенные темы, связанные с Cloud Firestore. Если вы только начинаете работать с Cloud Firestore, ознакомьтесь с кратким руководством.
Cloud Firestore – это гибкая масштабируемая база данных для разработки мобильных, веб- и серверных приложений от Firebase и Google Cloud. Начать работу с Cloud Firestore и создавать многофункциональные приложения очень просто.
Чтобы ваши приложения продолжали работать эффективно по мере увеличения размера базы данных и трафика, полезно понимать механику чтения и записи в бэкенде Cloud Firestore. Вы также должны понимать, как операции чтения и записи взаимодействуют с уровнем хранения и какие ограничения могут влиять на производительность.
Прежде чем разрабатывать архитектуру приложения, ознакомьтесь с рекомендациями в разделах ниже.
Основные компоненты
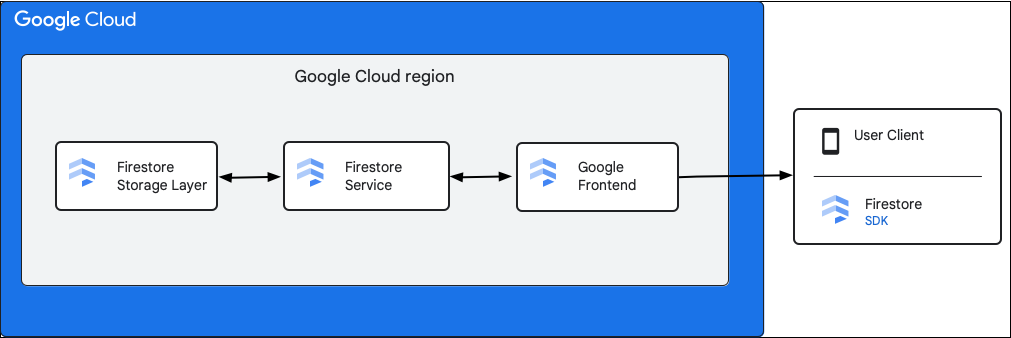
На схеме ниже показаны основные компоненты, задействованные в запросе к Cloud Firestore API.
SDK и клиентские библиотеки Cloud Firestore
Cloud Firestore поддерживает SDK и клиентские библиотеки для разных платформ. Хотя приложение может отправлять прямые HTTP- и RPC-вызовы в Cloud Firestore API, клиентские библиотеки предоставляют уровень абстракции, упрощающий использование API и реализацию рекомендаций. Они также могут предоставлять дополнительные функции, такие как офлайн-режим, кеширование и т. д.
Google Front End (GFE)
Это инфраструктурный сервис, общий для всех сервисов Google Cloud. GFE принимает входящие запросы и перенаправляет их в соответствующий сервис Google (в данном случае – Cloud Firestore). Кроме того, он обеспечивает защиту от DoS-атак и выполняет другие важные функции.
Сервисов: Cloud Firestore
Сервис Cloud Firestore выполняет проверки запроса к API, включая аутентификацию, авторизацию, проверку квот и правил безопасности, а также управляет транзакциями. Этот сервис Cloud Firestore включает клиент хранилища, который взаимодействует с уровнем хранилища для чтения и записи данных.
Уровень хранилища Cloud Firestore
Уровень хранения Cloud Firestore отвечает за хранение данных и метаданных, а также за связанные функции базы данных, предоставляемые Cloud Firestore. В следующих разделах описывается, как организованы данные на уровне хранения Cloud Firestore и как масштабируется система. Понимание того, как организованы данные, поможет вам разработать масштабируемую модель данных и лучше понять рекомендации по работе с Cloud Firestore.
Диапазоны клавиш и разделение клавиатуры
Cloud Firestore – это документоориентированная база данных NoSQL. Данные хранятся в документах, которые организованы в иерархические коллекции. Иерархия коллекций и идентификатор документа преобразуются в один ключ для каждого документа. Документы логически хранятся и упорядочиваются лексикографически по этому единственному ключу. Термин "диапазон ключей" относится к лексикографически непрерывному диапазону ключей.
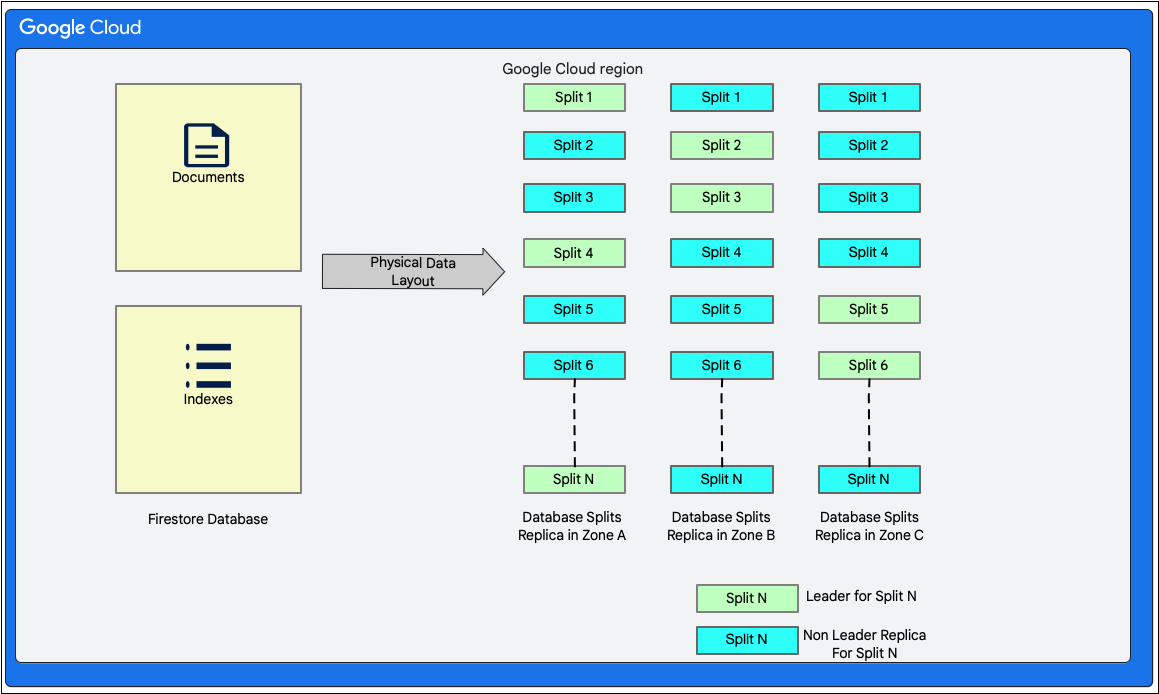
Обычно база данных Cloud Firestore слишком велика, чтобы поместиться на одном физическом компьютере. Также бывают ситуации, когда рабочая нагрузка на данные слишком велика для одной машины. Чтобы справляться с большими рабочими нагрузками, Cloud Firestore разбивает данные на отдельные части, которые могут храниться на нескольких компьютерах или серверах хранения и обслуживаться ими. Таблицы баз данных разбиваются на блоки диапазонов ключей, которые называются разбиениями.
Синхронная репликация
Важно отметить, что база данных всегда реплицируется автоматически и синхронно. Реплики фрагментов данных хранятся в разных зонах, чтобы обеспечить доступность данных, даже если одна из зон станет недоступна. Согласованная репликация в разные копии фрагмента управляется алгоритмом консенсуса Paxos. Одна реплика каждого фрагмента выбирается в качестве лидера Paxos, который отвечает за обработку записей в этот фрагмент. Синхронная репликация позволяет всегда считывать последнюю версию данных из Cloud Firestore.
В результате получается масштабируемая и высокодоступная система, которая обеспечивает низкие задержки как при чтении, так и при записи, независимо от тяжелых рабочих нагрузок и в очень больших масштабах.
Макет данных
Cloud Firestore – это база данных документов без схемы. Однако на уровне хранения данные размещаются в двух таблицах, похожих на таблицы реляционной базы данных:
- Таблица Documents. В ней хранятся документы.
- Таблица Indexes. В ней хранятся записи индексов, которые позволяют эффективно получать результаты, отсортированные по значению индекса.
На диаграмме ниже показано, как могут выглядеть таблицы для базы данных Cloud Firestore с разделением. Фрагменты реплицируются в три разные зоны, и каждому фрагменту назначается лидер Paxos.
Один регион или несколько
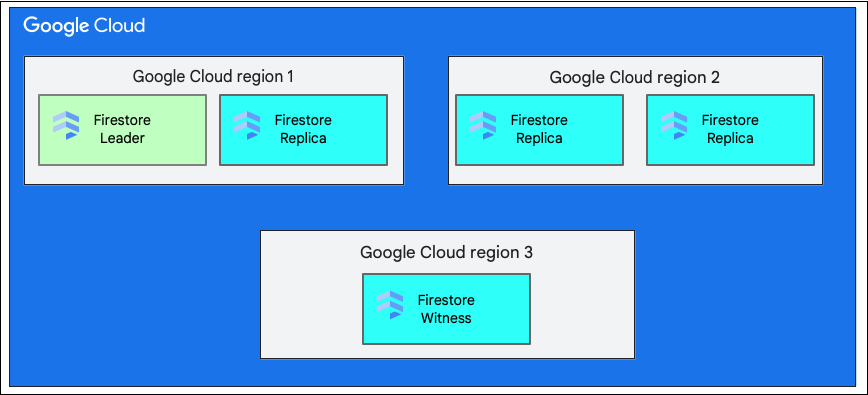
При создании базы данных необходимо выбрать регион или макрорегион.
Региональное местоположение – это определенная географическая область, например us-west1. Как уже говорилось, фрагменты данных базы Cloud Firestore имеют реплики в разных зонах выбранного региона.
Макрорегион состоит из определенного набора регионов, в которых хранятся реплики базы данных. В мультирегиональном развертывании Cloud Firestore в двух регионах есть полные реплики всех данных в базе данных. В третьем регионе находится реплика-свидетель, которая не хранит полный набор данных, но участвует в репликации. Благодаря репликации данных между несколькими регионами данные доступны для записи и чтения даже в случае потери целого региона.
Подробнее о местоположениях в регионе Cloud Firestore…
Понять, как работает запись в Cloud Firestore
Клиент Cloud Firestore может записывать данные, создавая, обновляя или удаляя один документ. Запись в один документ требует атомарного обновления как документа, так и связанных с ним записей индекса на уровне хранилища. Cloud Firestore также поддерживает атомарные операции, состоящие из нескольких операций чтения и/или записи в один или несколько документов.
Для всех видов записи Cloud Firestore предоставляет свойства ACID (атомарность, согласованность, изолированность и долговечность) реляционных баз данных. Cloud Firestore также обеспечивает сериализуемость, то есть все транзакции выполняются так, как если бы они выполнялись в последовательном порядке.
Основные этапы транзакции записи
Когда клиент Cloud Firestore выполняет запись или транзакцию, используя любой из упомянутых выше методов, на уровне хранилища это выполняется как транзакция чтения-записи базы данных. Транзакция позволяет Cloud Firestore обеспечивать свойства ACID, упомянутые ранее.
На первом этапе транзакции Cloud Firestore считывает существующий документ и определяет изменения, которые необходимо внести в данные в таблице Documents.
Вам также потребуется внести необходимые изменения в таблицу Indexes, как описано ниже.
- Поля, добавляемые в документы, должны иметь соответствующие вставки в таблице Indexes.
- Поля, которые удаляются из документов, должны быть удалены и из таблицы Indexes.
- Поля, которые изменяются в документах, требуют как удаления (для старых значений), так и вставки (для новых значений) в таблице Indexes.
Чтобы рассчитать изменения, упомянутые ранее, Cloud Firestore считывает конфигурацию индексирования для базы данных. Конфигурация индексирования содержит информацию об индексах базы данных. В Cloud Firestore используются два типа индексов: для одного поля и составные. Подробную информацию об индексах, созданных в Cloud Firestore, можно найти в статье Типы индексов в Cloud Firestore.
После расчета изменений Cloud Firestore собирает их в транзакцию и фиксирует ее.
Как работает транзакция записи на уровне хранилища
Как уже говорилось, запись в Cloud Firestore включает транзакцию чтения-записи на уровне хранилища. В зависимости от макета данных запись может включать одно или несколько разделений, как показано в макете данных.
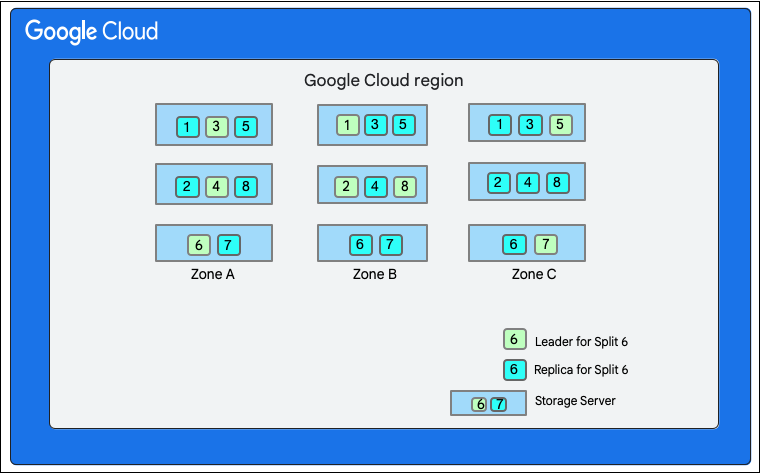
На следующей диаграмме показана база данных Cloud Firestore, разделенная на восемь частей (отмечены цифрами 1–8), которые размещены на трех разных серверах хранения в одной зоне. Каждая часть реплицируется в три(или более) разные зоны. У каждого сегмента есть лидер Paxos, который может находиться в разных зонах для разных сегментов.
 Разделение базы данных Cloud Firestore">
Рассмотрим базу данных Cloud Firestore, в которой есть коллекция Restaurants:
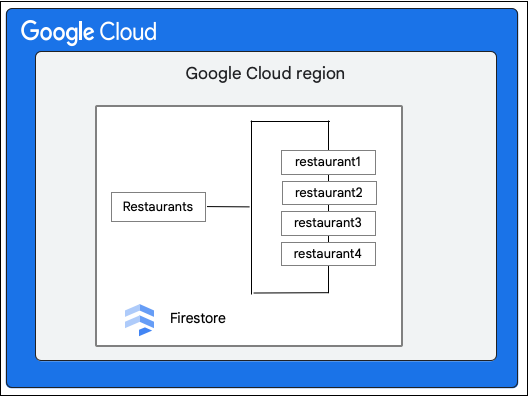
Клиент Cloud Firestore запрашивает изменение документа в коллекции Restaurant, обновляя значение поля priceCategory.
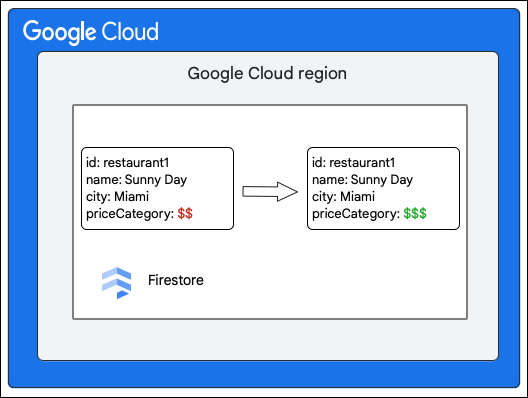
Ниже описаны основные этапы записи.
- Создайте транзакцию чтения-записи.
- Прочитайте документ
restaurant1в коллекцииRestaurantsиз таблицы Документы на уровне хранилища. - Прочитайте индексы документа из таблицы Индексы.
- Вычислите изменения, которые нужно внести в данные. В этом случае есть пять мутаций:
- M1: обновите строку для
restaurant1в таблице Документы, чтобы отразить изменение значения поляpriceCategory. - M2 и M3. Удалите строки со старым значением
priceCategoryв таблице Indexes для индексов по убыванию и возрастанию. - M4 и M5. Вставьте строки для нового значения
priceCategoryв таблицу Индексы для индексов по убыванию и возрастанию.
- M1: обновите строку для
- Зафиксируйте эти изменения.
Клиент хранилища в сервисе Cloud Firestore ищет разбиения, которым принадлежат ключи строк, подлежащих изменению. Предположим, что фрагмент 3 обслуживает M1, а фрагмент 6 – M2–M5. Распределенная транзакция включает все эти сегменты в качестве участников. В число фрагментов-участников также могут входить любые другие фрагменты, из которых ранее считывались данные в рамках транзакции чтения-записи.
Ниже описано, что происходит при фиксации.
- Клиент хранилища выполняет фиксацию. Фиксация содержит изменения M1–M5.
- В этой транзакции участвуют части 3 и 6. Один из участников выбирается в качестве координатора, например Split 3. Задача координатора – обеспечить атомарную фиксацию или отмену транзакции для всех участников.
- Реплики-лидеры этих фрагментов отвечают за работу, выполняемую участниками и координаторами.
- Каждый участник и координатор запускает алгоритм Paxos со своими репликами.
- Лидер запускает алгоритм Paxos с репликами. Кворум достигается, если большинство реплик отвечают лидеру
ok to commit. - Затем каждый участник уведомляет координатора о том, что он готов (первый этап двухэтапной фиксации). Если какой-либо участник не может зафиксировать транзакцию, вся транзакция
aborts.
- Лидер запускает алгоритм Paxos с репликами. Кворум достигается, если большинство реплик отвечают лидеру
- Когда координатор узнает, что все участники, включая его самого, готовы, он сообщает результат транзакции
acceptвсем участникам (второй этап двухэтапной фиксации). На этом этапе каждый участник записывает решение о фиксации в стабильное хранилище, и транзакция фиксируется. - Координатор сообщает клиенту хранилища в Cloud Firestore, что транзакция зафиксирована. Параллельно координатор и все участники применяют изменения к данным.
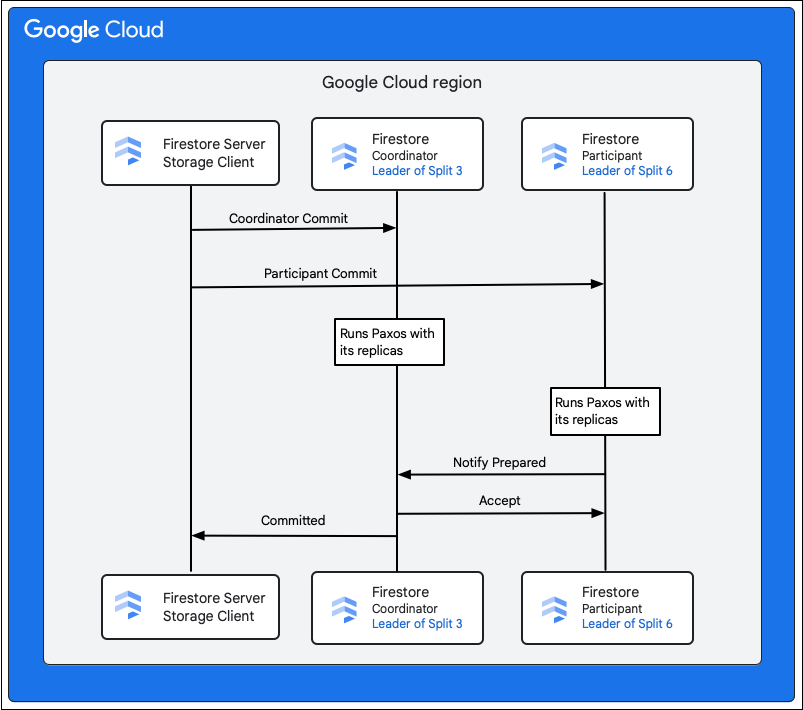
Если база данных Cloud Firestore небольшая, может случиться так, что один сплит будет владеть всеми ключами в изменениях M1–M5. В этом случае в транзакции участвует только один участник, и двухфазная фиксация, упомянутая ранее, не требуется, что ускоряет запись.
Запись в нескольких регионах
В мультирегиональном развертывании распределение реплик по регионам повышает доступность, но снижает производительность. Обмен данными между репликами в разных регионах занимает больше времени. Поэтому базовая задержка для операций Cloud Firestore немного выше, чем при развертывании в одном регионе.
Мы настраиваем реплики таким образом, чтобы управление разделением всегда оставалось в основном регионе. Основной регион – это регион, из которого трафик поступает на сервер Cloud Firestore. Это решение руководства сокращает задержку приема-передачи при обмене данными между клиентом хранилища в регионе Cloud Firestore и лидером реплики (или координатором транзакций с несколькими разбиениями).
Каждая запись в Cloud Firestore также включает в себя некоторое взаимодействие с механизмом реального времени в Cloud Firestore. Дополнительную информацию о запросах в реальном времени можно найти в статье Общие сведения о запросах в реальном времени в больших масштабах.
Жизненный цикл чтения в Cloud Firestore
В этом разделе рассматриваются отдельные операции чтения в Cloud Firestore, выполняемые не в режиме реального времени. Сервер Cloud Firestore обрабатывает большинство таких запросов в два основных этапа:
- Одно сканирование диапазона в таблице Indexes.
- Поиск по точкам в таблице Документы на основе результатов предыдущего сканирования.
Чтение данных из уровня хранения выполняется внутри системы с помощью транзакции базы данных, чтобы обеспечить согласованность чтения. Однако, в отличие от транзакций, используемых для записи, эти транзакции не блокируются. Вместо этого они работают, выбирая временную метку, а затем выполняя все операции чтения с этой временной меткой. Поскольку они не получают блокировки, они не блокируют параллельные транзакции чтения-записи. Чтобы выполнить эту транзакцию, клиент хранилища в Cloud Firestore указывает границу временной метки, которая сообщает уровню хранилища, как выбрать временную метку чтения. Тип границы временной метки, выбранный клиентом хранилища в Cloud Firestore, определяется параметрами чтения для запроса на чтение.
Как работает транзакция чтения на уровне хранилища
В этом разделе описываются типы операций чтения и то, как они обрабатываются на уровне хранилища в Cloud Firestore.
Хорошие показатели
По умолчанию операции чтения Cloud Firestore полностью согласованы. Такая полная согласованность означает, что при чтении Cloud Firestore возвращается последняя версия данных, отражающая все записи, зафиксированные до начала чтения.
Однократное чтение с разделением
Клиент хранилища в Cloud Firestore ищет фрагменты, которым принадлежат ключи строк, которые нужно прочитать. Предположим, что ему нужно выполнить чтение из фрагмента 3 из предыдущего раздела. Клиент отправляет запрос на чтение ближайшей реплике, чтобы сократить задержку туда и обратно.
В зависимости от выбранной реплики могут произойти следующие ситуации:
- Запрос на чтение отправляется в ведущую реплику (зона А).
- Поскольку лидер всегда имеет актуальные данные, чтение может выполняться напрямую.
- Запрос на чтение отправляется реплике, не являющейся лидером (например, в зоне B).
- Фрагмент 3 может определить по своему внутреннему состоянию, что у него достаточно информации для обслуживания чтения, и выполнить его.
- Разделение 3 не уверено, что у него есть последние данные. Она отправляет лидеру сообщение с запросом временной метки последней транзакции, которую нужно применить для чтения. После применения этой транзакции чтение может быть продолжено.
Затем Cloud Firestore возвращает ответ клиенту.
Чтение с несколькими разделениями
В ситуации, когда чтение должно выполняться из нескольких разделений, один и тот же механизм происходит во всех разделениях. После того как данные будут возвращены из всех фрагментов, клиент хранилища в Cloud Firestore объединит результаты. Cloud Firestore возвращает эти данные клиенту.
Устаревшие операции чтения
В Cloud Firestore по умолчанию используется строгая согласованность. Однако это может привести к увеличению задержки из-за необходимости связи с лидером. Часто приложению Cloud Firestore не требуется читать последнюю версию данных, и оно хорошо работает с данными, которые могут быть устаревшими на несколько секунд.
В этом случае клиент может выбрать получение устаревших данных, используя параметры чтения read_time. В этом случае чтение выполняется так, как если бы данные находились в read_time, и ближайшая реплика, скорее всего, уже подтвердила, что у нее есть данные в указанном read_time.
Для заметного повышения производительности разумным значением устаревания является 15 секунд. Даже при устаревших чтениях полученные строки согласуются друг с другом.
Избегайте горячих точек
Разделы в Cloud Firestore автоматически разбиваются на более мелкие части, чтобы распределить работу по обслуживанию трафика между большим количеством серверов хранения, когда это необходимо или когда пространство ключей расширяется. Разделения, созданные для обработки избыточного трафика, сохраняются в течение примерно 24 часов, даже если трафик исчезает. Поэтому, если всплески трафика повторяются, разделение сохраняется и при необходимости добавляются новые разделения. Эти механизмы помогают базам данных Cloud Firestore автоматически масштабироваться при увеличении нагрузки на трафик или размера базы данных. Однако у этого подхода есть ограничения, описанные ниже.
Разделение хранилища и нагрузки занимает время, и слишком быстрое увеличение трафика может привести к высокой задержке или ошибкам превышения срока, которые обычно называют горячими точками, пока сервис настраивается. Рекомендуется распределять операции по диапазону ключей, увеличивая трафик в коллекции в базе данных с 500 операциями в секунду. После этого увеличивайте трафик на 50% каждые пять минут. Этот процесс называется правилом 500/50/5. Он позволяет оптимально масштабировать базу данных в соответствии с рабочей нагрузкой.
Хотя разделение выполняется автоматически по мере увеличения нагрузки, Cloud Firestore может разделять диапазон ключей только до тех пор, пока он не будет обслуживать один документ с помощью выделенного набора реплицированных серверов хранения. В результате большое количество одновременных операций с одним документом может привести к возникновению горячей точки. Если вы сталкиваетесь с постоянно высокими задержками в одном документе, вам следует рассмотреть возможность изменения модели данных, чтобы разделить или реплицировать данные по нескольким документам.
Ошибки конкуренции возникают, когда несколько операций пытаются одновременно прочитать и/или записать один и тот же документ.
Другой особый случай возникновения горячих точек происходит, когда последовательно увеличивающийся/уменьшающийся ключ используется в качестве идентификатора документа в Cloud Firestore и выполняется значительно большое количество операций в секунду. Создание дополнительных сегментов не поможет, поскольку всплеск трафика просто переместится в новый сегмент. Поскольку Cloud Firestore по умолчанию автоматически индексирует все поля в документе, такие перемещающиеся горячие точки могут также создаваться в пространстве индекса для поля документа, которое содержит последовательно увеличивающееся или уменьшающееся значение, например временную метку.
Обратите внимание, что при соблюдении описанных выше рекомендаций Cloud Firestore может масштабироваться для обслуживания произвольно больших рабочих нагрузок без необходимости корректировать какую-либо конфигурацию.
Устранение неполадок
Key Visualizer – это инструмент диагностики в Cloud Firestore, предназначенный для анализа шаблонов использования и устранения проблем с горячими точками.
Что дальше
- Ознакомьтесь с другими рекомендациями.
- Подробнее о запросах в реальном времени…